
Cómo la inteligencia artificial acelera la detección, mejora la priorización y fortalece la coordinación, preservando al mismo tiempo el control humano sobre las decisiones de alto impacto.
La gestión de crisis ha cruzado su propio umbral. Ya no es una disciplina operativa alojada dentro de las funciones de TI o seguridad; es un imperativo de gobernanza a nivel de directorio, con consecuencias regulatorias, financieras y reputacionales directas.
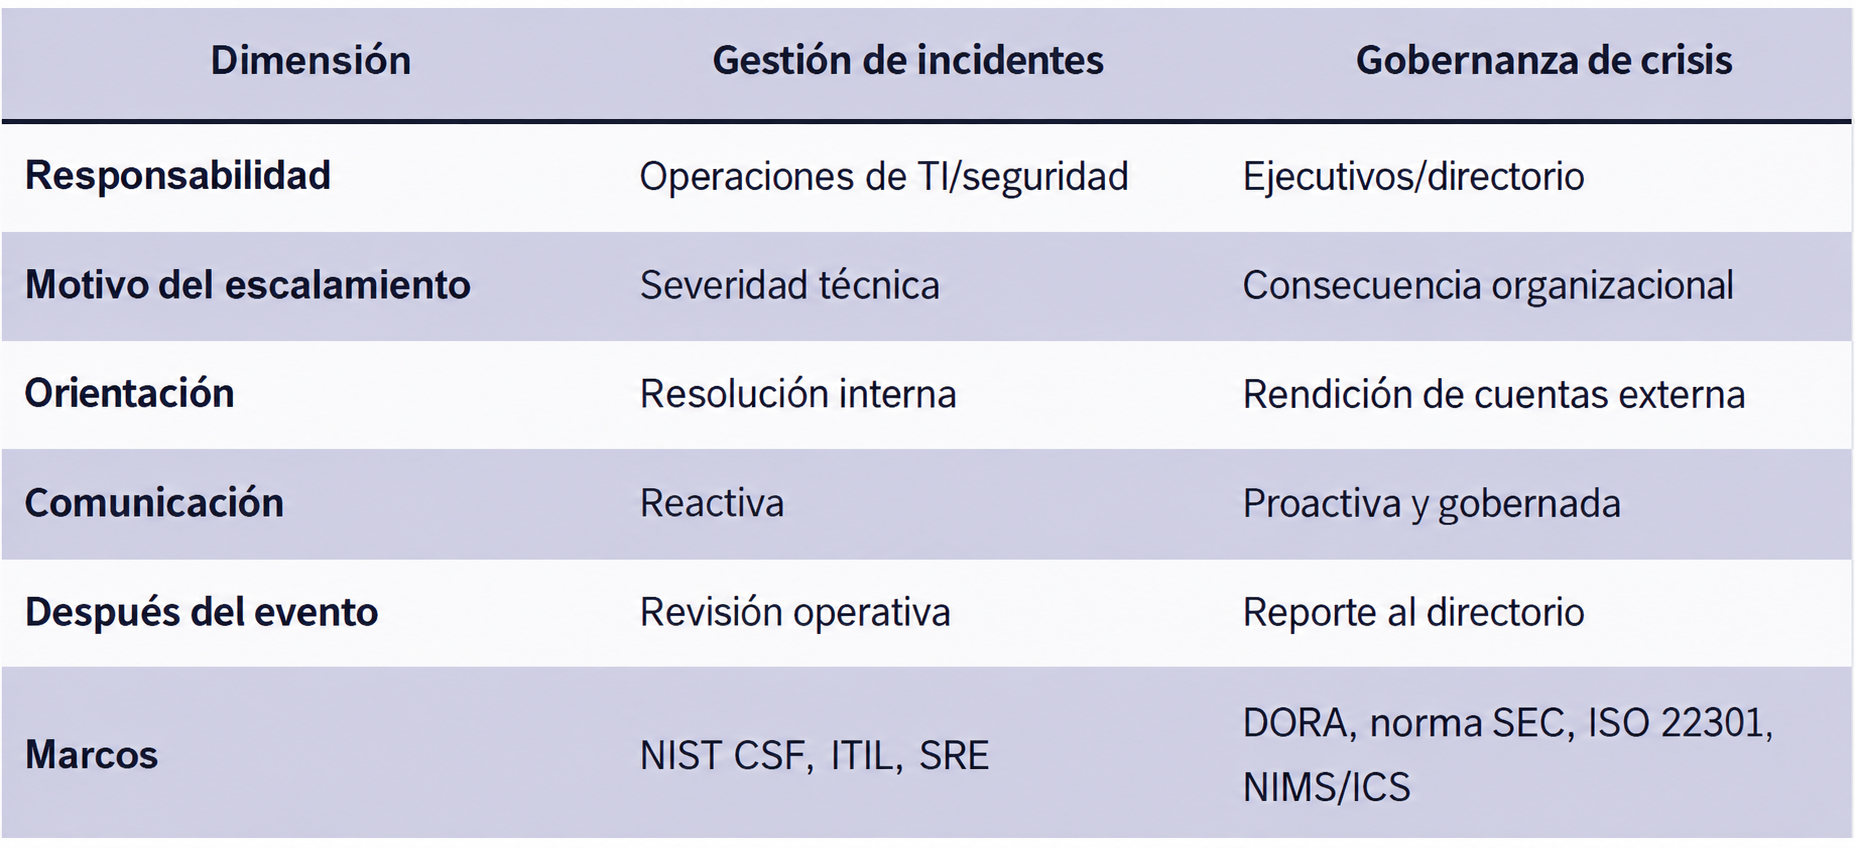
Cuando un incidente técnico obliga a los ejecutivos a tomar decisiones que implican distintos compromisos, activa obligaciones de divulgación o amenaza la confianza de los grupos de interés a gran escala, la organización ha entrado en territorio de crisis. La arquitectura de respuesta debe cambiar en consecuencia: pasar de una gestión procedimental de incidentes a una coordinación gobernada, con responsabilidades claramente definidas y múltiples grupos de interés.
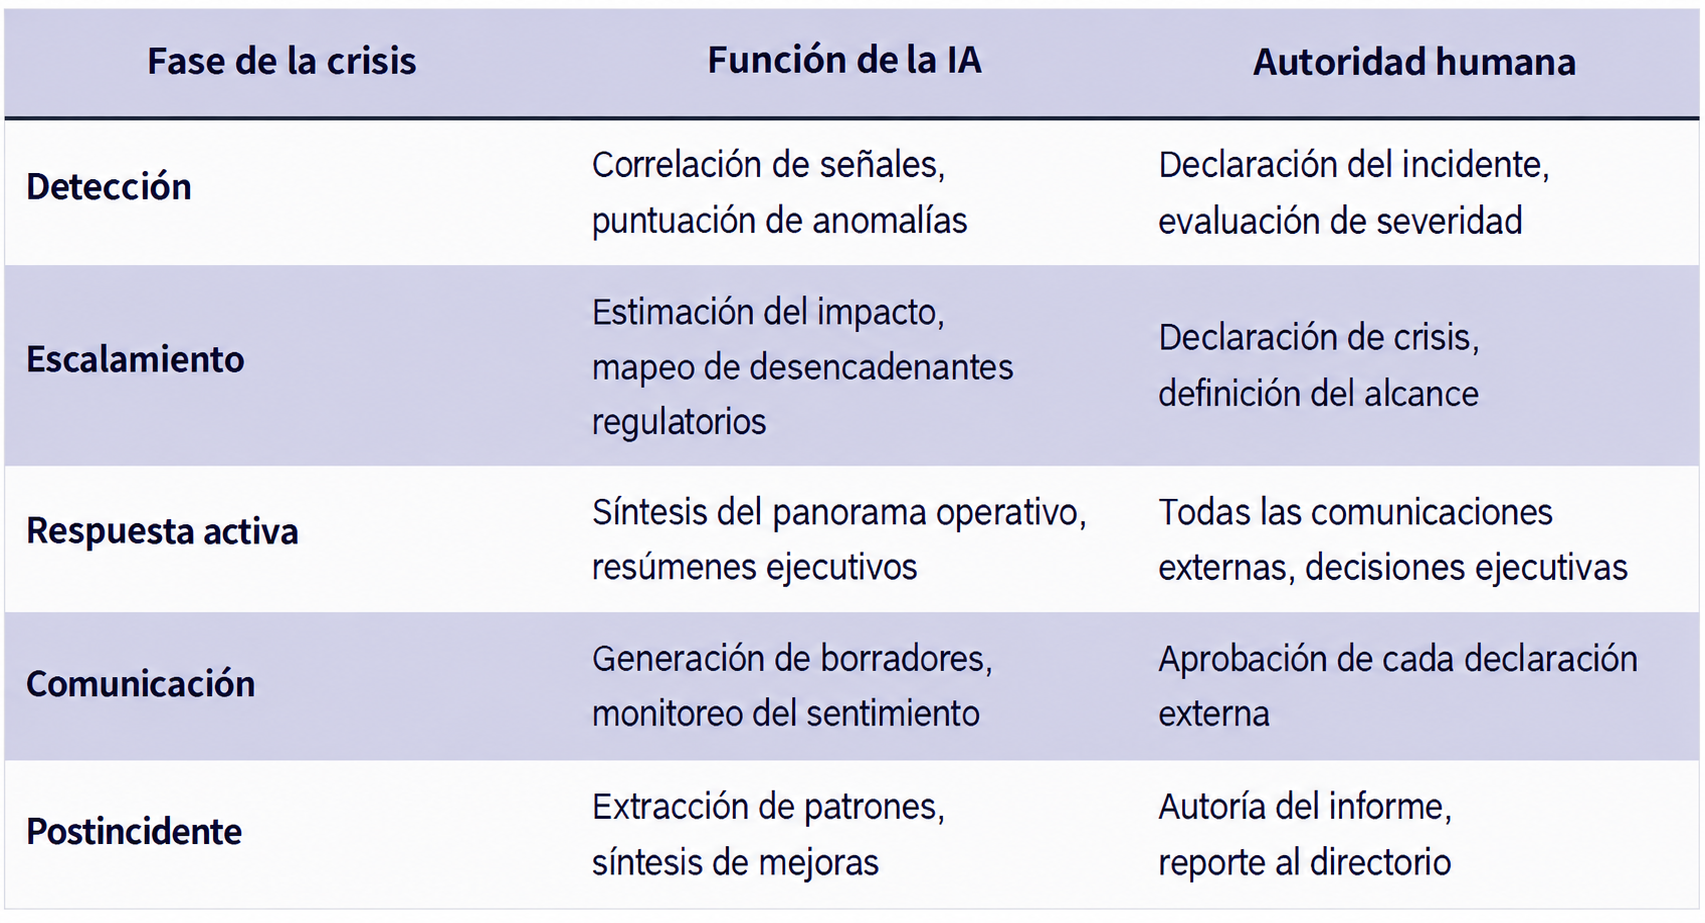
La inteligencia artificial fortalece significativamente esta respuesta al acelerar la detección de señales, permitir la correlación en tiempo real entre distintas fuentes de datos, generar información situacional preparada para los ejecutivos y poner a disposición precedentes históricos a la velocidad que exige la toma de decisiones. Sin embargo, la IA debe seguir siendo lo que es: un instrumento de apoyo a la toma de decisiones subordinado a la autoridad humana. El juicio, la responsabilidad y la comunicación externa deben permanecer exclusivamente en manos de personas calificadas.
Este artículo presenta un marco para la gestión de crisis aumentada por IA que prioriza la gobernanza, basado en NIST, ISO, las directrices regulatorias de la Unión Europea y las lecciones operativas derivadas de algunas de las crisis organizacionales más relevantes de 2021 a 2024.
Mensajes clave para la alta dirección
- Los criterios de escalamiento deben responder una pregunta: ¿qué consecuencias para la organización requieren ahora decisiones ejecutivas que impliquen compromisos y una rendición de cuentas externa?
- Un modelo operativo de crisis requiere seis elementos: umbral de escalamiento, estructura de comando del incidente, panorama operativo común, derechos de decisión, cadencia de comunicación y ciclo de aprendizaje.
- La IA aporta su mayor valor en los márgenes —detección temprana, síntesis rápida y recuperación de información histórica—, no en el centro de las decisiones de alto impacto.
- Una implementación confiable exige supervisión humana, trazabilidad, controles de seguridad, pruebas de sesgo y la capacidad estructural de desconectar completamente el sistema.
El umbral que lo redefine todo
Toda crisis organizacional comienza como algo más pequeño: una API degradada, un despliegue fallido, un pipeline que deja de responder. En esa etapa, el problema pertenece a ingeniería y al proceso de gestión de incidentes. La respuesta es procedimental. Las herramientas están maduras. La organización sabe cómo actuar.
El umbral que lo redefine todo no es una puntuación de severidad en un dashboard de monitoreo. Es el momento en que el incidente deja de ser exclusivamente un problema técnico y se convierte en un desafío de gobernanza organizacional.
Esa transición ocurre cuando la disrupción operativa alcanza uno o más de los siguientes ámbitos:
- Autoridad ejecutiva: las decisiones y los compromisos necesarios exceden el mandato operativo.
- Obligación regulatoria: se activan requisitos de divulgación, notificación o auditoría.
- Impacto material sobre los grupos de interés: se ven comprometidos los SLA, la seguridad de los pacientes, el procesamiento financiero o la infraestructura crítica.
- Contagio de terceros: la falla de un proveedor o socio agrava la exposición de la organización.
- Riesgo reputacional: el escrutinio de los medios de comunicación, político o social es inminente o ya está activo.
Tres eventos reflejan este patrón.
CrowdStrike Falcon (julio de 2024). Las actualizaciones de sensores del 19 de julio de 2024 provocaron la caída de aproximadamente 8,5 millones de sistemas Windows en cuestión de horas, obligando a aerolíneas, hospitales, medios de comunicación y entidades gubernamentales a tomar decisiones de continuidad a nivel ejecutivo antes de que los equipos de ingeniería hubieran determinado por completo la causa técnica.
Change Healthcare (febrero de 2024). Un ciberataque interrumpió durante semanas el procesamiento de reclamaciones de farmacias en todo el sistema sanitario estadounidense, provocando intervención regulatoria, comparecencias ante el Congreso y un informe de la OFR sobre la exposición financiera sistémica; ninguno de estos era un resultado para el cual un proceso de gestión de incidentes estuviera diseñado para gobernar.
AWS us-east-1 (diciembre de 2021). Una falla en cascada se propagó más allá de los clientes directos de AWS hacia la logística de entregas, dispositivos para hogares inteligentes y portales de atención médica, generando un desafío de comunicación entre múltiples grupos de interés que ninguna organización podía gestionar por sí sola.
Estos eventos comparten un mismo patrón estructural: la falla técnica generó consecuencias que solo podían abordarse mediante autoridad ejecutiva, rendición de cuentas externa y comunicación coordinada entre grupos de interés ajenos a la cadena original del incidente. Eso es una crisis. Y exige un modelo operativo fundamentalmente diferente.
El imperativo de la gobernanza
El cambio más significativo en la gestión moderna de crisis es organizacional, no tecnológico. Durante la última década, la respuesta a crisis organizacionales estuvo ubicada dentro de TI, operaciones de seguridad o continuidad del negocio: funciones con experiencia operativa, pero estructuralmente alejadas de la rendición de cuentas a nivel de directorio. Ese posicionamiento ya no es defendible.
Tres fuerzas han elevado la gestión de crisis al nivel de una función de gobernanza.
Velocidad regulatoria
La Ley de Resiliencia Operativa Digital de la Unión Europea (DORA), vigente desde enero de 2025, exige la clasificación de incidentes de TIC, la notificación a las autoridades competentes dentro de plazos establecidos y la responsabilidad del directorio sobre la estrategia de resiliencia. La Ley de IA de la UE amplía las obligaciones de cumplimiento a implementaciones de IA de alto riesgo, incluyendo requisitos de notificación de incidentes. Las empresas públicas estadounidenses están sujetas a la norma de divulgación de ciberseguridad de la SEC, que exige informar sobre incidentes materiales dentro de los cuatro días hábiles, una determinación que requiere consideración a nivel de directorio.
Riesgo de concentración
La consolidación de proveedores de hiperescala y SaaS significa que la falla de un único proveedor ya no es bilateral: es sistémica. El incidente de CrowdStrike generó daños estimados superiores a los mil millones de dólares en distintos sectores. Las organizaciones afectadas por un mismo evento desencadenante tienen diferentes obligaciones regulatorias, perfiles de exposición y grupos de interés, lo que exige respuestas específicas para cada contexto y, al mismo tiempo, coordinadas externamente.
Velocidad del escrutinio
La aceleración de las redes sociales, la cobertura en tiempo real de la prensa financiera y el monitoreo regulatorio han reducido a horas el intervalo entre la detección de un evento y los comentarios externos. La decisión sobre qué comunicar, a quién y cuándo es una determinación relevante para el directorio, con consecuencias financieras materiales; no es simplemente un asunto que el equipo de comunicaciones deba escalar.
Un modelo operativo de crisis de seis elementos
Una gobernanza eficaz de crisis no requiere una infraestructura diseñada específicamente para cada evento. Requiere una arquitectura preestablecida de roles, autoridades, cadencias y herramientas que pueda activarse de manera confiable bajo presión. El siguiente modelo sintetiza NIST SP 800-61r3, ISO 22301, NIMS/ICS y la investigación sobre organizaciones de alta confiabilidad.
Umbral de escalamiento
Los criterios de crisis deben definirse antes de que ocurra una disrupción. Los umbrales establecidos en el momento están sujetos a sesgos cognitivos y efectos de anclaje. Los marcos más robustos aplican una evaluación en dos ejes: amplitud de las consecuencias y desencadenantes de gobernanza, previamente valorados mediante indicadores específicos de la organización. No escalar cuando corresponde resulta, de manera consistente, el modo de falla más costoso.
Estructura de comando del incidente
La unidad de mando —un único líder de crisis con autoridad transversal, distinto del comandante del incidente técnico— elimina la ambigüedad de coordinación que los análisis posteriores a los incidentes identifican repetidamente como una causa raíz de respuestas tardías. El líder de crisis gobierna la respuesta organizacional; el líder técnico dirige la remediación. Ambos trabajan a partir de un panorama común.
Panorama operativo comú
La asimetría de información es el principal mecanismo de falla en el desempeño de equipos que trabajan en situaciones de alto impacto. El líder de crisis necesita una síntesis seleccionada y continuamente actualizada que incluya: estado técnico, grupos de interés afectados, acciones activadas, decisiones pendientes e inteligencia externa. Esto no es un dashboard; es un instrumento de apoyo a la toma de decisiones.
Derechos de decisión
La ambigüedad respecto de la autoridad es una de las fuentes más comunes de retrasos. Los derechos de decisión previamente establecidos deben abarcar declaraciones externas, notificaciones regulatorias, activación de cláusulas de fuerza mayor, adquisiciones de emergencia y compensaciones a clientes. La declaración de crisis debe activar automáticamente estas autoridades; no deben quedar bloqueadas por las cadenas de aprobación utilizadas durante las operaciones habituales.
Cadencia de comunicación
La comunicación de crisis mantiene las relaciones de confianza que la organización necesitará después de la resolución del evento. Una cadencia estructurada especifica la frecuencia de los reportes internos, los formatos de notificación externa, los protocolos de divulgación regulatoria y la autoridad frente a los medios, vinculándolos explícitamente con los plazos de DORA y la SEC cuando corresponda.
Ciclo de aprendizaje
La revisión posterior al incidente debe abordar no solo la falla técnica, sino también las fallas de la respuesta: brechas de información, autoridades poco claras y retrasos en la comunicación. Se requieren tres resultados: un informe interno de mejora, actualizaciones del modelo operativo y un resumen de rendición de cuentas dirigido al directorio. Las organizaciones que cierran este ciclo sistemáticamente demuestran un desempeño considerablemente superior en eventos posteriores.
La capa de aumento mediante IA
El argumento a favor de la IA en la gestión de crisis no es la autonomía, sino el aumento de las capacidades humanas. La IA mejora significativamente la calidad de las decisiones precisamente en aquellos momentos en los que la complejidad amenaza con sobrepasar la capacidad cognitiva humana.
Un análisis publicado en 2025 en Computer Science Review examinó la IA a lo largo del ciclo de gestión de desastres y encontró evidencia consistente de su valor para la detección de señales, la integración de múltiples fuentes, la predicción de impactos y la optimización de recursos, con una conclusión central: la IA funciona mejor como apoyo a la toma de decisiones que mejora la conciencia situacional, no como un agente autónomo que sustituye el juicio humano.
Cinco ámbitos ofrecen valor inmediato y justificable:
Detección temprana de señales
Los modelos de aprendizaje automático entrenados con datos históricos de incidentes identifican patrones precursores a una velocidad y escala que superan la capacidad humana de monitoreo. El valor es asimétrico: disponer de horas adicionales de preparación antes de que el evento se haga público tiene un impacto desproporcionado sobre la calidad de la respuesta.
Correlación de múltiples fuentes
Los eventos de crisis se presentan como conjuntos de señales distribuidas entre sistemas diferentes. La IA realiza una correlación continua entre sistemas, identificando hipótesis sobre posibles causas comunes, algo fundamental para determinar correctamente el alcance antes de declarar una crisis.
Estimación del impacto
La IA proporciona estimaciones estructuradas de prioridad basadas en similitudes históricas, acompañadas de márgenes explícitos de incertidumbre y presentadas como apoyo para la decisión, no como instrucciones. El líder de crisis conserva plena autoridad para aceptarlas, modificarlas o rechazarlas.
Síntesis ejecutiva
Los modelos de lenguaje de gran escala destacan por su capacidad para transformar el estado técnico en comunicaciones preparadas para ejecutivos, generando informes continuamente actualizados sin necesidad de producirlos manualmente bajo presión. La revisión humana antes de su difusión sigue siendo innegociable.
Recuperación de casos históricos
La IA amplía la capacidad del líder de crisis para reconocer patrones mediante la recuperación estructurada de eventos similares, acciones de respuesta y resultados provenientes de una base de evidencia más amplia de la que cualquier persona podría mantener por sí sola.
Implementación responsable: requisitos de gobernanza innegociables
El aumento mediante IA está condicionado a una implementación responsable. Las directrices de NIST, ENISA y el marco regulatorio de la Unión Europea convergen en una serie de requisitos que las organizaciones deben cumplir antes de implementar IA en funciones de apoyo a decisiones con consecuencias significativas.
Sesgo de automatización
La tendencia a confiar en los resultados automatizados —especialmente intensa bajo presión de tiempo— exige medidas explícitas de mitigación: niveles de confianza en todos los resultados, ejercicios periódicos que incluyan deliberadamente recomendaciones incorrectas generadas por IA y verificación humana obligatoria antes de cualquier comunicación externa.
Explicabilidad
Los líderes de crisis no pueden evaluar recomendaciones provenientes de sistemas opacos. La IA debe proporcionar atribución de fuentes e indicadores de confianza significativos. Los resultados de «caja negra» son inapropiados cuando una única recomendación incorrecta puede generar consecuencias materiales.
Seguridad y robustez frente a ataques adversariales
Los sistemas de IA utilizados durante una crisis son objetivos de alto valor para los atacantes. Requieren controles de seguridad equivalentes a los de una infraestructura crítica: controles de acceso, registros de auditoría, pruebas adversariales y monitoreo de resultados anómalos. Una capa de IA comprometida constituye un incidente, no simplemente una falla de una herramienta.
Sesgo y cambio en la distribución de los datos
Los modelos entrenados con datos históricos reflejan las limitaciones de esa distribución. Las pruebas periódicas de sesgo en distintos tipos de escenarios y el monitoreo de cambios en la distribución son requisitos previos para su implementación. Los eventos novedosos son precisamente aquellos en los que la IA resulta menos confiable y, paradójicamente, aquellos en los que es más probable que sea consultada.
Capacidad de intervención humana y desconexión
El requisito más fundamental es estructural: los operadores deben poder intervenir o desconectar la IA en cualquier momento sin degradar la capacidad principal de respuesta. Los sistemas de IA que se convierten en puntos únicos de falla no son herramientas de apoyo: son vulnerabilidades.
Hoja de ruta para la implementación
Las organizaciones que busquen desarrollar la capacidad de gobernanza de crisis descrita en este artículo no necesitan hacerlo todo al mismo tiempo. El siguiente enfoque por fases permite obtener valor tangible desde etapas tempranas mientras se avanza hacia un modelo operativo maduro aumentado por IA. Se basa en las orientaciones combinadas de ISO 22301, NIST SP 800-61r3 y las prácticas emergentes de implementación de DORA adoptadas por organizaciones líderes del sector financiero.
Fundamentos (0–90 días)
Objetivo: establecer la arquitectura humana del modelo operativo de crisis antes de realizar cualquier inversión en IA.
- Definir la matriz de umbrales de escalamiento con desencadenantes específicos y observables para cada categoría de consecuencias.
- Designar al líder de crisis y al patrocinador ejecutivo, con autoridades de decisión claramente documentadas.
- Documentar seis canales de comunicación y sus respectivas cadenas de aprobación: estado interno, notificación a clientes, notificación regulatoria, declaración a medios de comunicación, divulgación a inversionistas y comunicación con socios.
- Realizar un ejercicio de escritorio utilizando un escenario basado en un evento reciente del sector para someter el modelo a prueba.
- Completar un análisis de brechas que identifique dónde son actualmente más débiles la disponibilidad de información, la velocidad de decisión y la preparación de las comunicaciones.
Criterio de éxito: la organización puede declarar una crisis, conformar el equipo y ejecutar la respuesta utilizando el modelo de seis elementos sin apoyo de IA.
Capa de señales mediante IA (90–180 días)
Objetivo: introducir el aumento mediante IA en las capas de detección y correlación, el punto de entrada de mayor valor y menor riesgo.
- Auditar la infraestructura existente de monitoreo y telemetría para identificar las fuentes de datos que pueden alimentar los modelos de IA para detección de señales.
- Seleccionar o configurar un sistema de detección mediante IA con requisitos explícitos de explicabilidad, atribución de fuentes e indicadores de confianza.
- Integrar la capa de señales de IA con la matriz de umbrales de escalamiento, de manera que los patrones detectados generen recomendaciones estructuradas de escalamiento en lugar de simples alertas.
- Establecer el marco de gobernanza para el sistema de IA: controles de acceso, registros de auditoría, protocolo de pruebas de sesgo y procedimientos de desconexión.
- Capacitar al equipo de crisis en flujos de trabajo aumentados por IA, incluyendo ejercicios específicos destinados a practicar la evaluación crítica de los resultados generados por esta tecnología.
Criterio de éxito: la capa de IA genera recomendaciones de escalamiento accionables que el equipo de crisis puede evaluar, aceptar o rechazar con confianza.
Comunicación ejecutiva e integración del aprendizaje (180–365 días)
Objetivo: extender el aumento mediante IA a la comunicación ejecutiva y al aprendizaje posterior al incidente.
- Implementar capacidades de síntesis ejecutiva, incorporando requisitos de revisión humana en cada punto del flujo de trabajo en el que el contenido generado por IA pueda llegar a una audiencia externa.
- Crear o acceder a un repositorio estructurado de informes postincidente provenientes tanto de eventos internos como de casos del sector, para respaldar la recuperación de casos históricos mediante IA.
- Integrar los resultados del aprendizaje postincidente en la matriz de umbrales de escalamiento y en el marco de derechos de decisión, cerrando así el ciclo entre eventos pasados y la arquitectura de respuesta futura.
- Realizar una simulación de crisis a escala completa con el aumento mediante IA activo, evaluando tanto la calidad del apoyo generado por la IA como la capacidad del equipo de crisis para operar cuando la capa de IA sea degradada deliberadamente.
- Publicar un informe interno de gobernanza sobre la implementación de IA en la gestión de crisis, que incluya datos de desempeño, resultados de pruebas de sesgo y compromisos de mejora, estableciendo así un registro de rendición de cuentas organizacional.
Criterio de éxito: el modelo operativo completo aumentado por IA funciona en condiciones realistas y la organización puede demostrar tanto su capacidad como su gobernanza ante los reguladores y el directorio.
Conclusión
El entorno organizacional ha cambiado de manera irreversible. Cuando una actualización de sensores deja fuera de servicio 8,5 millones de dispositivos, cuando un ciberataque paraliza el procesamiento de reclamaciones de farmacias para decenas de millones de personas, cuando una falla en la nube se propaga simultáneamente por la logística, la atención médica y la infraestructura de consumo, el incidente técnico siempre puede convertirse en una crisis.
La IA es un verdadero multiplicador de capacidades: detección más temprana, correlación más rápida, priorización más precisa, inteligencia preparada para ejecutivos generada en minutos y recuperación de información histórica que amplía incluso el repertorio del líder de crisis más experimentado. Estas capacidades pueden implementarse hoy dentro de marcos de gobernanza ya establecidos por NIST, ISO y la regulación de la Unión Europea.
Pero siguen estando condicionadas a ciertos principios: elegir la explicabilidad por encima del rendimiento cuando ambos entren en conflicto; preservar la capacidad manual en lugar de permitir la dependencia; y mantener la autoridad humana sobre todas las comunicaciones externas.
¿Cuándo se convierte el incidente en una crisis? Cuando las consecuencias para la organización exigen autoridad ejecutiva y rendición de cuentas externa.
Las organizaciones más resilientes tomarán esa decisión deliberadamente, antes de que la próxima crisis las obligue a hacerlo.
Declaración
La autora declara no tener ningún conflicto de interés relacionado con la investigación y las organizaciones mencionadas en este artículo. Las opiniones expresadas pertenecen a la autora y no representan necesariamente la posición oficial de Microsoft.
 NIKITA SARAN
Nikita Saran es gestora de crisis en Microsoft, donde lidera la respuesta organizacional ante crisis, la gobernanza del escalamiento, la coordinación de grupos de interés y las comunicaciones ejecutivas durante incidentes de alto impacto.
Su trabajo se centra en fortalecer la arquitectura de gobernanza de crisis, desarrollar capacidades de conciencia situacional y facilitar una toma de decisiones efectiva entre los líderes técnicos y de negocio. Cuenta con experiencia especializada en la intersección entre inteligencia artificial, marcos estructurados de comunicación y resiliencia organizacional.
